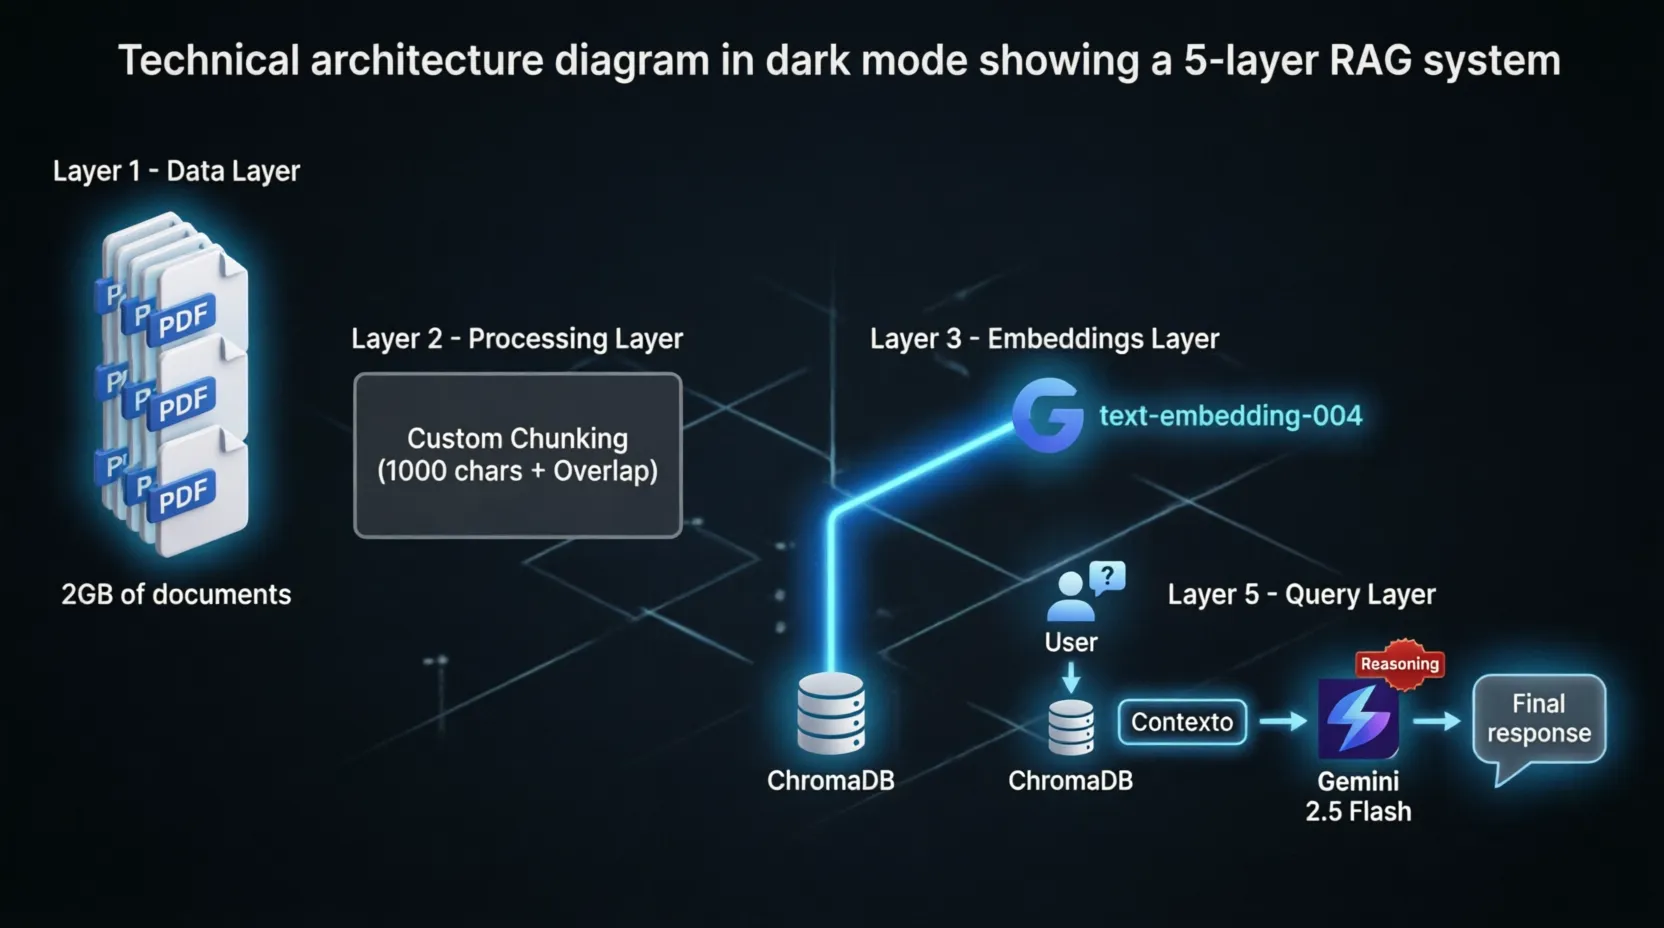
Guía: Cómo construir un sistema RAG para 2GB de datos con Gemini 2.5 Flash y ChromaDB
RAG con Gemini 2.5 Flash y ChromaDB: guía para 2GB de datos
Aprende a construir un sistema RAG desde cero para procesar GB de datos usando Gemini 2.5 Flash, ChromaDB y Python. Evita alucinaciones y optimiza costos.
1. La Arquitectura
Para procesar un volumen de 2GB (aprox. 500,000 trozos de texto), necesitamos una cadena eficiente:
- Extracción: Procesamiento de PDFs con PyMuPDF.
- Chunking Inteligente: División de texto sin romper palabras y con solapamiento.
- Vectorización: Uso de
text-embedding-004(ogemini-embedding-001). - Almacenamiento: ChromaDB para persistencia de vectores.
- Inferencia: Gemini 2.5 Flash aprovechando su capacidad de razonamiento.
| Enfoque | Qué hace | Cuándo conviene | Riesgo principal |
|---|---|---|---|
| RAG con Gemini 2.5 Flash y ChromaDB | Recupera fragmentos relevantes del corpus y los pasa al modelo | Datos de 2 GB que cambian con frecuencia | Dividir mal el texto es el 80% del éxito, y también del fracaso |
| Fine-tuning | Ajusta los pesos del modelo con ejemplos etiquetados | Ya no está disponible en la API de Gemini; solo supervised tuning en Vertex AI | No es una opción dentro de la API pública |
| Prompt largo sin recuperación | Manda el documento completo en cada consulta | Corpus muy pequeños | El costo de tokens crece con cada consulta |
| Plataforma SaaS de chat con PDF | RAG ya resuelto por el proveedor | Validar la idea rápido | Cuota mensual y el dato vive fuera de tu infraestructura |
2. Preparación del Envierno
Instalamos las dependencias necesarias. Usaremos el nuevo SDK de Google GenAI:
pip install -q -U google-genai chromadb pymupdf
3. El Chunking: El secreto de la precisión
Dividir el texto correctamente es el 80% del éxito en RAG. Esta función asegura que no cortemos palabras a la mitad y mantengamos un solapamiento real.
def chunkear_texto(texto, tamano=1000, solapamiento=200):
    trozos = []
    inicio = 0
    while inicio < len(texto):
        fin = min(inicio + tamano, len(texto))

        if fin < len(texto):
            ultimo_espacio = texto.rfind(' ', inicio, fin)
            if ultimo_espacio != -1:
                fin = ultimo_espacio

        pedazo = texto[inicio:fin].strip()
        if pedazo:
            trozos.append(pedazo)

        inicio = fin - solapamiento
        if inicio >= fin: inicio = fin + 1
        if fin >= len(texto): break
    return trozos
Quizas el código anterior es un poco difícil de entender, en su defecto se puede usar este otro:
def chunkear_texto(texto, tamano:int=1000, solapamiento:int=200):
    pedazos = []
    inicio = 0
    while inicio < len(texto):
        fin = min(inicio + tamano, len(texto))
        if fin - inicio < tamano:
            pedazos.append(texto[inicio:fin].strip())
            break

        trozo = texto.rfind(' ', inicio, fin)
        if trozo != -1:
            pedazos.append(texto[inicio:fin].strip())

        solapamiento_exacto = texto.rfind(' ', inicio, trozo-solapamiento)
        inicio = solapamiento_exacto

    return pedazos
4. Extracción y Carga en ChromaDB
Usamos PyMuPDF por su alto rendimiento procesando archivos pesados.
import fitz
import chromadb

client_db = chromadb.PersistentClient(path="./db_manuales")
coleccion = client_db.get_or_create_collection(
    name="documentacion_tecnica",
    metadata={"hnsw:space": "cosine"}
)

def procesar_y_almacenar_pdf(ruta_pdf):
    doc = fitz.open(ruta_pdf)
    for i, pagina in enumerate(doc):
        texto = pagina.get_text()
        chunks = chunkear_texto(texto)

        for j, chunk in enumerate(chunks):
            id_chunk = f"{ruta_pdf}_{i}_{j}"
            coleccion.add(
                documents=[chunk],
                ids=[id_chunk],
                metadatas=[{"source": ruta_pdf, "page": i}]
            )
5. Embeddings con el nuevo SDK
Aquí definimos la función para convertir texto en vectores usando el modelo más reciente.
from google import genai
from google.genai import types

client = genai.Client(api_key="TU_API_KEY")

def obtener_embedding(texto):
    result = client.models.embed_content(
        model="text-embedding-004", # O gemini-embedding-001
        contents=texto,
        config=types.EmbedContentConfig(task_type="RETRIEVAL_QUERY")
    )
    return result.embeddings[0].values
6. Consulta y Razonamiento (Reasoning)
Gemini 2.5 Flash puede "razonar" sobre los fragmentos recuperados. Esto es vital para descartar información contradictoria en manuales técnicos.
def generar_respuesta(pregunta):
    # 1. Convertir pregunta a vector y buscar en ChromaDB
    query_vector = obtener_embedding(pregunta)
    resultados = coleccion.query(
        query_embeddings=[query_vector],
        n_results=5
    )

    contexto = "\n\n".join(resultados['documents'][0])

    # 2. Generar respuesta con capacidades de razonamiento
    prompt = f"""Actúa como un ingeniero experto. Analiza el contexto y responde la pregunta.
    Usa tu capacidad de razonamiento para validar los datos antes de responder.

    Contexto:
    {contexto}

    Pregunta: {pregunta}

    Si la información no está en el contexto, indícalo. No inventes datos técnicos."""

    response = client.models.generate_content(
        model="gemini-2.5-flash",
        contents=prompt
    )
    return response.text
7. Optimizando Costos: Context Caching
Si tu documentación de 2GB es estática, no necesitas enviar los mismos datos una y otra vez. Gemini 2.5 permite crear un Context Cache.
- ¿Cómo funciona? Subes los documentos una vez al servidor de Google, se crea un caché con un TTL (tiempo de vida) y tus consultas RAG apuntan a ese caché.
- Ahorro: Reduces el costo de tokens de entrada hasta en un 80% en chats largos.
| Modelo | Entrada en USD por 1M de tokens | Salida en USD por 1M de tokens | Contexto |
|---|---|---|---|
| Gemini 2.5 Flash | USD 0,30 | USD 2,50 | 1.048.576 tokens |
| Gemini 2.5 Flash-Lite | USD 0,10 | USD 0,40 | No indicado |
| Gemini 2.5 Flash Preview | USD 0,15 | USD 1,00 | No indicado |
Conclusión
Implementar RAG a escala requiere precisión en el chunking y un modelo de lenguaje que sepa separar el ruido de la información valiosa. Gemini 2.5 Flash, junto con ChromaDB, ofrece una solución de nivel empresarial con un costo de mantenimiento mínimo.
Fuentes consultadas:
- [1] Documentación oficial de Gemini Embeddings (Google AI)
- [2] ChromaDB: Core Concepts & Persistence Docs
- [3] Paper: Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
- [4] PyMuPDF (Fitz) Documentation
¿Estás escalando un sistema RAG y tienes problemas con la latencia? Dejame tus dudas en los comentarios o contactame para una consultoría técnica.
¿Necesitas un proyecto de software a medida?
Cada sistema debe pensarse para tu operación: alcance definido, presupuesto claro y fechas reales.
Escríbenos por WhatsApp y te respondemos en menos de 24 horas hábiles.
También puedes estimar el retorno con nuestra calculadora de ROI de automatización.
Articulos relacionados
- ¿Cuánto cuesta una app para monitoreo de rutas y entregas de última milla para farmacias?
- ¿Cuánto cuesta implementar un software de gestión de pedidos para distribuidores de repuestos automotrices?
- ¿Cuánto cuesta implementar un sistema a medida para control de trazabilidad en plantas de reciclaje?
- ¿Cuánto cuesta el desarrollo de panel de control para empresas de servicios de limpieza industrial en 2026?
- ¿Cuánto cuesta implementar un sistema de reservas online open source guía 2026?
- ¿Cuánto cuesta implementar un sistema de control de calidad y producción para pequeñas empresas de artes gráficas?
- Guía de Desarrollo: Cómo crear un Bot de WhatsApp con IA para tu empresa
- software a medida precios guia 2026 contratacion
¿Cuánto pierdes al mes sin automatizar?
Usa la calculadora de ROI: te estima en segundos cuánto te devuelve automatizar soporte, data entry o WhatsApp con IA. Matemática honesta y salarios reales de LATAM.
Calcular mi ROI